Mitä on tekninen hakukoneoptimointi?
Tekninen hakukoneoptimointi (tekninen SEO, puhekielessä myös tekninen optimointi) tarkoittaa sivuston rakenteen, nopeuden ja indeksoitavuuden kuntoon laittamista. Se vastaa kolmeen kysymykseen:
- Löytääkö Google sivusi? Crawlaus, robots.txt, sivukartta ja sisäiset linkit.
- Ymmärtääkö Google sivusi? Renderöinti, canonical-tagit ja rakennedata.
- Toimiiko sivu käyttäjälle? Nopeus, mobiili ja HTTPS.
Tekninen SEO ei ole sisällön kirjoittamista eikä linkkien hankkimista. Se on perusta, jonka päälle kaikki muu hakukoneoptimointi rakentuu.
Tekninen SEO ratkaisee eniten kolmessa tilanteessa: sivusto ei indeksoidu, sivu on niin hidas, että kävijä poistuu ennen sisältöä, tai Google crawlaa vääriä sivuja ja ohittaa tärkeät.
Teknisen hakukoneoptimoinnin osa-alueet
Korjaa ensin asiat, jotka estävät indeksoinnin tai rikkovat sivun käytön. Hio yksityiskohtia vasta sen jälkeen. Taulukko kertoo, miltä kunnossa oleva osa-alue näyttää ja mistä tunnistat ongelman.
| Osa-alue | Hyvä merkki | Hälytysmerkki |
|---|---|---|
| Crawlaus ja indeksointi | Tärkeät sivut ovat Search Consolen mukaan indeksissä | Sivukartassa on sivuja, joita Google ei indeksoi |
| Sivukartta | Sisältää vain julkaistut, indeksoitavat sivut | Mukana 404-sivuja, uudelleenohjauksia tai noindex-sivuja |
| Robots.txt | Ei estä CSS-, JavaScript-, kuva- tai sisältöpolkuja | Tärkeä kansio on estetty vahingossa |
| Canonical ja duplikaatit | Jokaisella sivulla on oikea, itseensä osoittava canonical | Canonical osoittaa väärään sivuun tai noindex-sivuun |
| Nopeus | LCP alle 2,5 s ja CLS alle 0,1 mobiilissa | Pääkuva, fontit tai skriptit viivästyttävät latausta |
| Rakennedata | Validi JSON-LD, joka kuvaa näkyvää sisältöä | Virheitä Rich Results Testissä tai tyypit eivät vastaa sivua |
| Sisäiset linkit | Jokainen tärkeä sivu löytyy 1–3 klikkauksella | Tärkeitä sivuja ei linkitetä mistään |
| Renderöinti | Sisältö on valmiina HTML:ssä | Sisältö syntyy vasta selaimessa JavaScriptillä |
Crawlaus ja indeksointi
Crawlaus on teknisen SEO:n lähtöpiste: jos Google ei löydä sivujasi, se ei voi indeksoida niitä.
Googlen crawler (Googlebot) käy läpi sivustosi seuraamalla linkkejä sivulta toiselle. Se ei automaattisesti löydä kaikkia sivuja. Sinun tehtäväsi on varmistaa, että Googlebot löytää oikeat sivut ja jättää turhat rauhaan.
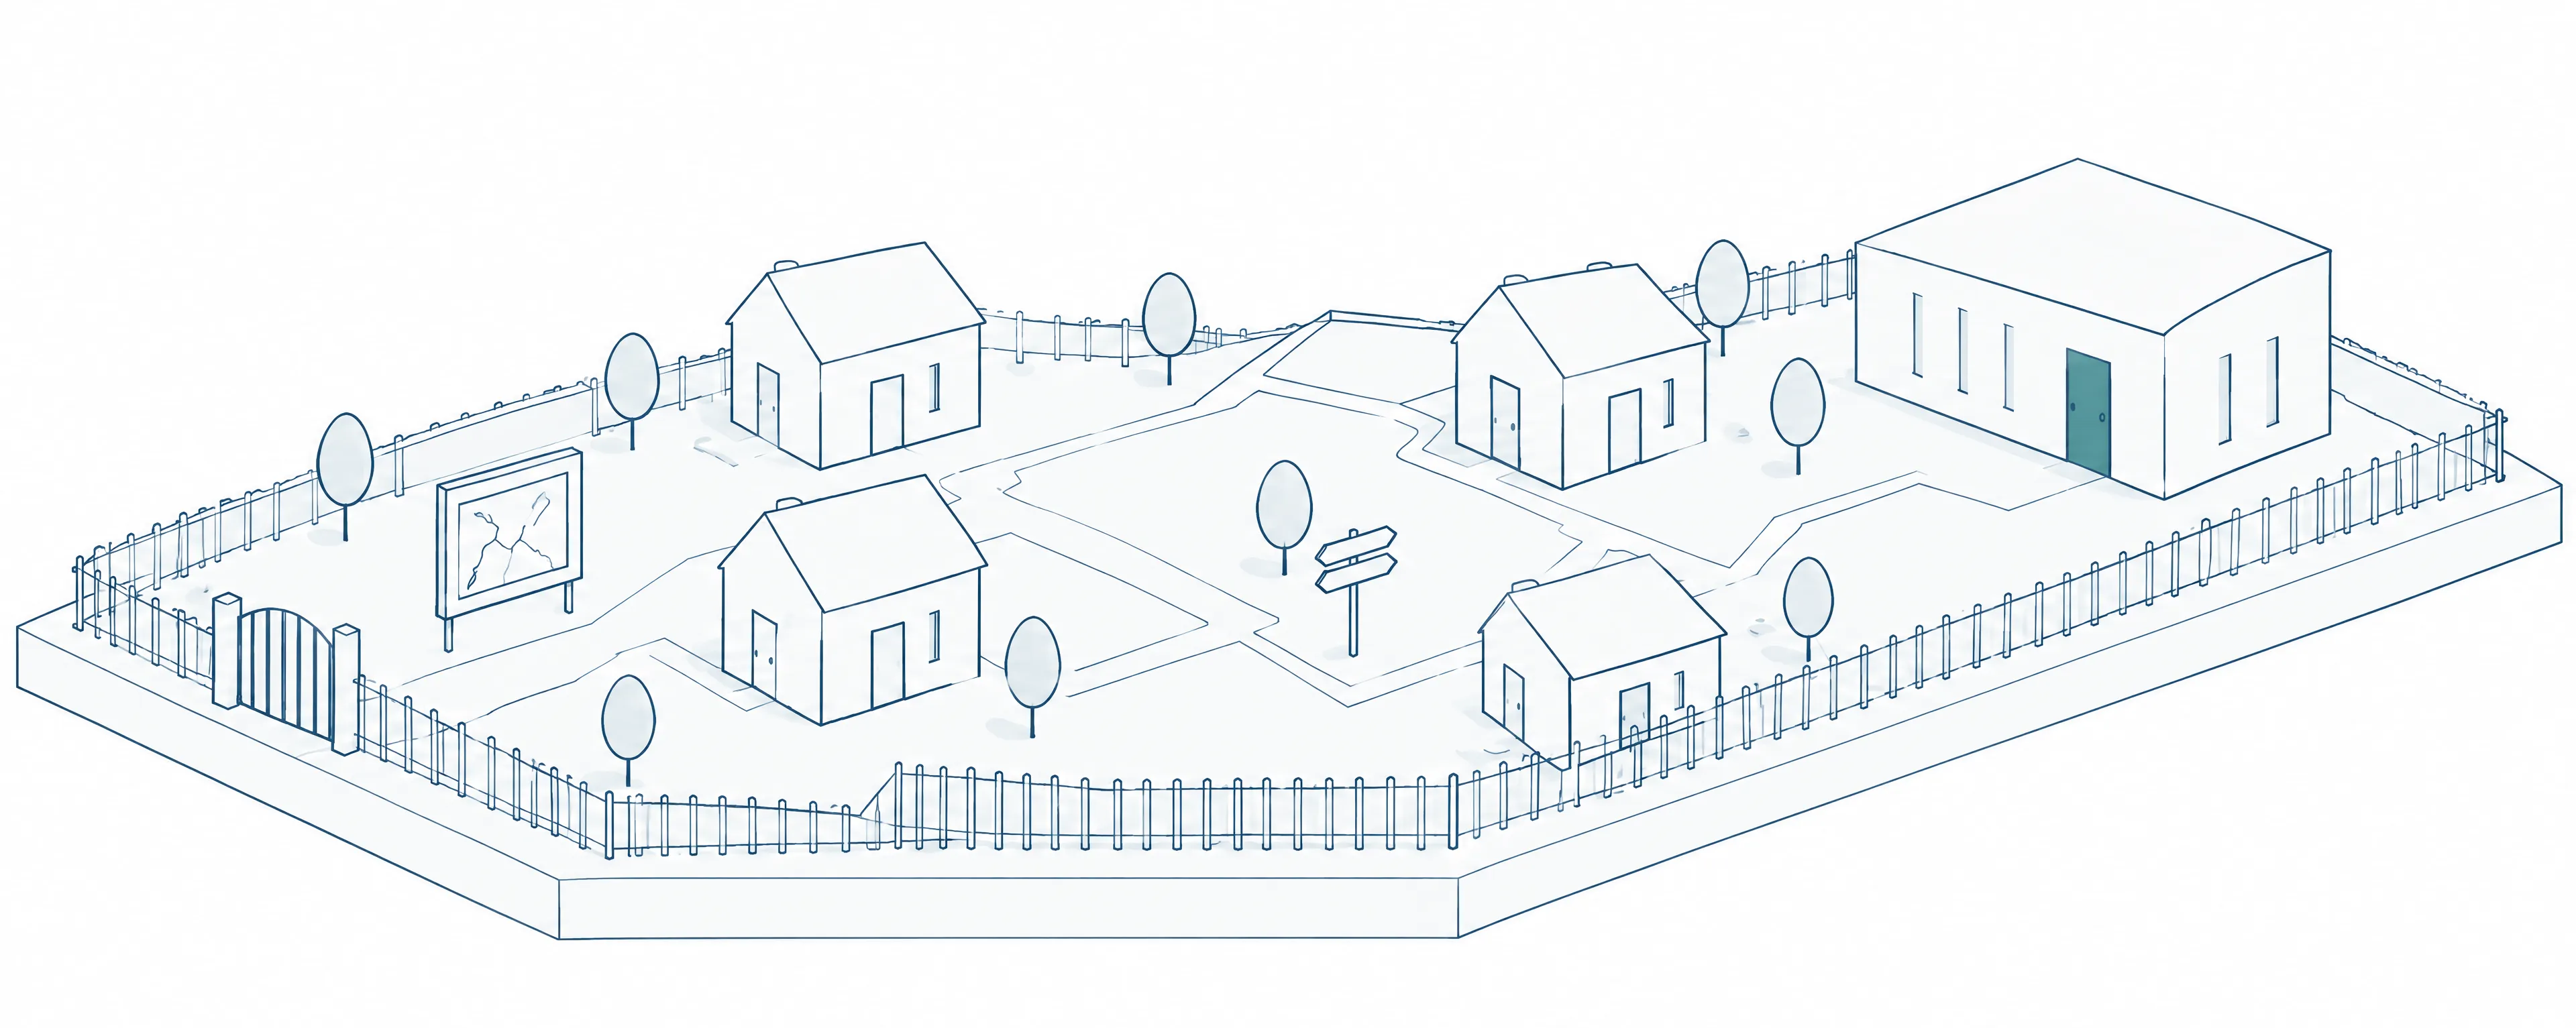 robots.txtSivukarttaSisäiset linkitCanonicalIndeksi robots.txtSivukarttaSisäiset linkitCanonicalIndeksi
Crawlaus ja indeksointi ovat kaksi eri vaihetta. Crawlauksessa Googlebot hakee sivun. Indeksoinnissa Google arvioi sen ja päättää, lisätäänkö se hakuindeksiin. Crawlauksen estää yleensä robots.txt, palvelinvirhe tai se, ettei sivulle johda yhtään linkkiä. Indeksoinnin estää noindex-merkintä, toiseen osoitteeseen viittaava canonical, ohut sisältö tai duplikaatti.
Robots.txt
Robots.txt on tekstitiedosto sivuston juuressa. Se kertoo hakukoneille, mitä polkuja ne saavat crawlata. Se ei ole suojaus: Google voi indeksoida estetyn osoitteen, jos siihen linkitetään muualta.
Yleisin virhe on estää CSS- tai JavaScript-tiedostot. Silloin Google ei pysty renderöimään sivua oikein. Tarkista Search Consolen URL-tarkistuksella, näkeekö Google sivun samoin kuin käyttäjä.
Ote tämän sivuston robots.txt:stä Kaikki hakukoneet ja tekoälycrawlerit sallittu, sivukartan osoite mukana.
User-agent: *
Allow: /

Content-Signal: search=yes, ai-input=yes, ai-train=yes

User-agent: GPTBot
Allow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: ClaudeBot
Allow: /

User-agent: PerplexityBot
Allow: /

Sitemap: https://jondillemuth.fi/sitemap.xml
Tekoälycrawlerit on sallittu erikseen, koska osa CDN-palveluista estää ne oletuksena. Erillinen Allow tekee päätöksestä näkyvän. Koko tiedostossa on lisäksi muun muassa Google-Extended, Applebot-Extended ja CCBot.
XML-sivukartta
Sivukartta luettelee sivut, jotka haluat Googlen indeksoivan. Se ei takaa indeksointia, mutta nopeuttaa uusien sivujen löytymistä. Tarkista sivukartta jokaisen auditoinnin alussa:
- Sivukartta aukeaa ilman virhettä, ja robots.txt viittaa oikeaan osoitteeseen.
- Jokainen osoite palauttaa 200-vastauksen. Mukana ei ole noindex-sivuja, uudelleenohjauksia eikä canonicalin ohittamia sivuja.
lastmodmuuttuu vain, kun sisältö oikeasti muuttuu.- Sivukartta on lähetetty Search Consoleen, ja Google on lukenut sen äskettäin.
Bing ja Yandex tukevat lisäksi IndexNow-rajapintaa, joka ilmoittaa uudesta tai muuttuneesta sivusta heti. Google ei tue IndexNow’ta, mutta Bingissä se nopeuttaa indeksointia selvästi.
Indeksointiongelmat
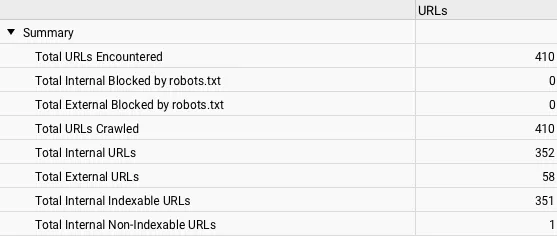
Search Consolen Sivut-raportti kertoo, mitkä sivut ovat indeksissä ja miksi loput eivät ole. Screaming Frog näyttää saman sivuston omasta näkökulmasta yhdellä crawlilla.
| Syy, miksi sivua ei indeksoida | Korjaus |
|---|---|
| Noindex-merkintä | Poista meta robots noindex, jos sivun kuuluu näkyä haussa |
| Canonical osoittaa toiseen sivuun | Korjaa canonical osoittamaan sivuun itseensä |
| Soft 404 | Sivu palauttaa 200, mutta sisältö on tyhjä: täydennä sisältö tai palauta 404 |
| Palvelinvirhe | Selvitä 5xx-vastaukset ja aikakatkaisut palvelimen lokeista |
| Ohut sisältö | Kirjoita sivulle oikeaa sisältöä tai yhdistä se toiseen sivuun |
Nopein tarkistus on Google-haku site:domain.fi/sivu/. Jos sivua ei näy, se ei ole indeksissä. Jos sivukartassa on 100 sivua ja indeksissä 30, aloita Search Consolen suurimmasta poissulkemisen syystä.
Canonical-tagit
Canonical-tagi kertoo Googlelle, mikä on sivun ensisijainen osoite. Sama sisältö voi olla saatavilla monesta osoitteesta: kauttaviivalla ja ilman, http:// ja https://, www-etuliitteellä ja ilman sekä seurantaparametrien (?utm_source=linkedin) kanssa. Ilman canonicalia linkkien arvo voi jakautua näiden versioiden kesken.
Paras käytäntö on itseensä osoittava canonical jokaisella sivulla, myös silloin, kun duplikaatteja ei ole:
<link rel="canonical" href="https://domain.fi/blogi/artikkeli/" />Yleiset virheet:
- Canonical osoittaa noindex-sivuun. Google saa ristiriitaisen signaalin.
- Canonical osoittaa eri sisältöön. Google voi ohittaa sen kokonaan.
- Canonical puuttuu. Google arvaa itse, mikä versio on ensisijainen.
- Suhteellinen osoite (
href="/"). Toimii, mutta absoluuttinen osoite on varmempi.
URL-rakenne
Hyvä osoite kertoo sekä Googlelle että käyttäjälle, mistä sivulla on kyse, ennen kuin sitä on avattu.
| Tarkistus | Hyvä toteutus | Riski |
|---|---|---|
| Pituus ja kuvaavuus | /palvelut/seo-konsultointi/ | /p/12345/ tai polku, jossa on päivämäärä ja turhia sanoja |
| Merkistö | Pienet kirjaimet a–z, numerot ja väliviivat | Ääkköset, isot kirjaimet, alaviivat tai erikoismerkit |
| Hierarkia | Tärkeä sivu enintään kolmen tason syvyydessä | /kategoria/alakategoria/ala-alakategoria/sivu/ |
| Parametrit | Sisältö omassa osoitteessaan | ?ref=email&session=abc123 luo uusia osoitteita samalle sisällölle |
| Pysyvyys | Osoite ei muutu otsikon pienen päivityksen takia | Vuosiluku tai kampanjan nimi pakottaa myöhemmin uudelleenohjaukseen |
Title, metakuvaus ja hakutuloksen ulkoasu
Title ja metakuvaus ovat myös tekninen tarkistus: tuottaako sivusto jokaiselle indeksoitavalle sivulle oman titlen ja kuvauksen? Google voi kirjoittaa kuvauksen uudelleen, mutta oma kuvaus antaa sille lähtökohdan.
| Elementti | Tarkistus | Korjaus |
|---|---|---|
| Title | Jokaisella indeksoitavalla sivulla on oma title | Luo title-pohja ja etsi duplikaatit Screaming Frogilla |
| H1 | Sivulla on yksi pääotsikko, joka vastaa sen aihetta | Älä tee useita H1-otsikoita komponenttien sisään |
| Metakuvaus | Kuvaus on sivukohtainen ja vastaa hakuaikeeseen | Kirjoita palvelu- ja artikkelisivuille käsin |
| Hakutulos | Title ei katkea pahasti, ja kuvaus lupaa oikean asian | Testaa tärkeimmät sivut hakutuloksen esikatselulla |
Älä optimoi titleä irrallaan sisällöstä. Jos title lupaa tarkistuslistan, sivulla pitää olla tarkistuslista. Muuten klikkausprosentti voi nousta hetkeksi, mutta kävijä poistuu nopeasti.
Duplikaattisisältö
Duplikaattisisältö tarkoittaa, että sama tai lähes sama sisältö on saatavilla useasta osoitteesta. Harvoin kyse on kopioinnista: useimmiten sivuston tekniikka tuottaa duplikaatit itse. Seurauksena linkkien arvo jakautuu, crawlaus kuluu samaan sisältöön ja Google voi näyttää haussa väärän version.
| Mistä duplikaatti syntyy | Korjaus |
|---|---|
| www ja ilman www:tä | 301-uudelleenohjaus yhteen versioon |
| http ja https | 301 kaikesta http-liikenteestä https:ään |
| Kauttaviiva lopussa ja ilman | Valitse yksi muoto ja ohjaa toinen siihen |
| URL-parametrit (lajittelu, seuranta) | Canonical parametrittomaan versioon |
| Sama tuote monessa kategoriassa | Canonical pääversioon tai kategoriasta riippumaton tuoteosoite |
Verkkokaupan suodattimet ja variantit tuottavat duplikaatteja eniten. Ne käydään läpi verkkokaupan hakukoneoptimoinnin oppaassa.
Ohut sisältö
Ohut sisältö tarkoittaa sivuja, joilla on niin vähän tekstiä, ettei Google pidä niitä indeksoinnin arvoisina. Korjaus riippuu sivutyypistä:
| Sivutyyppi | Korjaus |
|---|---|
| Listasivu (blogin etusivu, kategoria) | Lyhyt johdanto: mitä aiheita osio kattaa ja kenelle |
| Turha sivu (arkisto, tagi, parametrisivu) | Noindex tai poisto |
| Arvokas mutta ohut sivu (palvelu, tuote) | Lisää sisältöä: mitä palvelu sisältää, kenelle se sopii, mitä tuloksia odottaa |
| Generoitu sivu (suodatinvariantti) | Canonical pääversioon tai noindex |
Duplikaatit ja ohut sisältö tällä sivustolla Screaming Frog 12.10.2026: ei duplikaatteja, kolme ohutta listasivua.
Screaming Frog -crawl 12.10.2026 löysi 0 täydellistä ja 0 lähes identtistä duplikaattia 46 HTML-sivulta. Kaikilla 46 sivulla on itseensä osoittava canonical. Tähän riittää kolme asetusta: kauttaviiva aina osoitteen lopussa, canonical jokaiselle sivulle automaattisesti ja pelkkä https (http ohjautuu 301:llä).
Ohuita sivuja on kolme, ja kaikki ovat listasivuja: case-studyt (99 sanaa), auditoinnit (162 sanaa) ja englanninkielinen case studies -sivu (129 sanaa). Korjaus on taulukon ensimmäinen rivi: lyhyt johdanto, joka kertoo, mitä osio sisältää ja kenelle se on.
Miten Core Web Vitals vaikuttaa hakutulossijoituksiin?
Core Web Vitals on Googlen kolmen mittarin kokonaisuus, joka arvioi käyttäjäkokemusta: latausnopeutta (LCP), reagointia (INP) ja visuaalista vakautta (CLS). Google käyttää sijoituksissa oikeiden käyttäjien kenttädataa (CrUX), joten huono tulos voi pudottaa sijoituksia. PageSpeed Insightsin laboratoriotulos on kehityksen apuväline.
LCP on useimmiten se mittari, joka ratkaisee. Korjaa ensin suurin pullonkaula: jos LCP-elementti on 800 kilotavun kuva, JavaScriptin siivous ei auta, ja jos palvelin vastaa hitaasti, kuvien pakkaaminen ei poista viivettä.
| LCP-ongelma | Korjaus |
|---|---|
| Suuret kuvat | WebP tai AVIF, srcset eri näytöille, lazy load muille kuin pääkuvalle |
| Hidas palvelin (TTFB) | CDN, staattinen generointi, välimuisti reunalla |
| Renderöintiä estävä CSS tai JavaScript | Kriittinen CSS sivun sisään, JavaScript defer-attribuutilla |
| Web-fontit | font-display: optional tai swap ja preload |
| Kolmannen osapuolen skriptit | Tagienhallinta, analytiikka ja mainokset asynkronisesti |
INP korvasi FID:n maaliskuussa 2024, ja se on ongelma lähinnä sivustoilla, joissa on raskas selaimessa ajettava JavaScript (Googlen INP-dokumentaatio). CLS korjataan antamalla jokaiselle kuvalle mitat (width ja height tai aspect-ratio) ja varaamalla tila myöhemmin latautuvalle sisällölle.
Esimerkki: tämä sivusto 93:sta sataan
Sivusto on rakennettu Astrolla staattiseksi HTML:ksi ilman selaimessa ajettavaa sovelluskehystä. Julkaisun jälkeen etusivun mobiilitulos oli 93. Neljä pientä korjausta vei sen sataan:
Etusivu julkaisun jälkeen
93 / 100
Etusivu 12.10.2026, parempi vaihtoehto
100 / 100
Mitä 93:sta sataan vaati Fontin latausstrategia, CSS sivun sisään, esilataus ja kuvien prioriteetti.
- Fontin latausstrategia.
font-display: swapvaihtui muotoonoptional, ja fontille lisättiinpreload. Tekstin hyppy latauksessa poistui, ja LCP parani. - CSS sivun sisään. Kaikki tyylit kirjoitetaan HTML:ään (
inlineStylesheets: "always"), joten viimeinen renderöintiä estävä tiedosto poistui. - Speculation Rules. Seuraava sivu esiladataan taustalla ennen kuin kävijä klikkaa.
- Kuvien prioriteetti. Pääkuvalla
fetchpriority="high", muillaloading="lazy", ja jokaisella kuvalla srcset kolmella leveydellä.
Jokainen muutos nosti tulosta 1–3 pistettä. Lisäksi varafontti on säädetty size-adjust-arvolla samankokoiseksi, joten fontin vaihtuminen ei siirrä sivun osia.
Kuvien optimointi teknisessä SEO:ssa
Kuvat ovat usein helpoin tekninen voitto: ne vaikuttavat latausnopeuteen, LCP:hen, saavutettavuuteen ja kuvahakuun. Tavoite ei ole puristaa kaikkea mahdollisimman pieneksi, vaan antaa selaimelle oikean kokoinen kuva oikeassa muodossa.
| Tarkistus | Hyvä toteutus | Miksi |
|---|---|---|
| Muoto | AVIF tai WebP | Pienempi tiedosto ilman näkyvää laadun heikkenemistä |
| Mitat | width ja height tai CSS aspect-ratio | Estää CLS-hypyt latauksen aikana |
| Responsiivisuus | srcset ja sizes | Mobiili ei lataa työpöydän kokoista kuvaa |
| Lazy load | loading="lazy" kuville, jotka eivät näy heti | Ensimmäinen näkymä latautuu nopeammin |
| Pääkuva | fetchpriority="high" eikä lazy loadia | Suurin näkyvä elementti latautuu ensin |
| Alt-teksti | Kuvaa kuvan sisällön ja tarkoituksen | Saavutettavuus ja kuvahaku |
Yleisin virhe on lisätä loading="lazy" myös pääkuvalle. Selain saa silloin luvan ladata kuvan liian myöhään, ja LCP hidastuu. Alt-tekstissä riittää tarkka kuvaus: “Screaming Frog -crawl, jossa näkyvät vastauskoodit” auttaa, avainsanojen luettelo ei.
Mobile first -indeksointi
Google arvioi sivut mobiiliversion perusteella (Googlen mobile-first-dokumentaatio). Jos mobiilista puuttuu sisältöä, joka näkyy työpöydällä (taulukot, UKK tai sisäiset linkit piilotettuna CSS:llä), Google ei näe sitä. Hidas mobiilisivu heikentää sijoituksia myös työpöytähaussa.
Responsiivinen sivusto (sama HTML, CSS mukauttaa näkymän) on suositeltavin ratkaisu. Erillinen m.-sivusto vaatii canonical- ja hreflang-määritykset ja on altis virheille. Tarkista mobiilissa ainakin nämä:
- Painikkeet ja linkit ovat vähintään 48 × 48 pikseliä ja riittävän kaukana toisistaan.
- Teksti on luettavaa ilman zoomausta (vähintään 16 px).
- Sivu ei vieri vaakasuunnassa.
- Koko ruudun peittävä ponnahdusikkuna ei estä sisältöä heti latauksen jälkeen. Pienet bannerit ja evästeilmoitukset ovat sallittuja.
HTTPS ja tietoturvaheaderit
HTTPS on perusedellytys, ei kilpailuetu. Se on ollut Googlen sijoitussignaali vuodesta 2014, ja ilman sitä selaimet varoittavat kävijää. Perustasolla tarvitaan sertifikaatti (Let’s Encrypt on ilmainen), 301-uudelleenohjaus http:stä https:ään, HSTS ja sivu, joka ei lataa mitään resurssia http:llä (mixed content).
Tällä sivustolla Screaming Frog 12.10.2026: kaikki sivut https:llä, 0 mixed content -varoitusta ja HSTS jokaisella sivulla. Jos siirrät WordPress-sivustoa https:ään, käy järjestys läpi WordPress HTTPS -ohjeesta.
Tietoturvaheaderit ja sähköpostin todennus Eivät nosta sijoituksia suoraan, mutta vahvistavat luotettavuutta.
| Header | Mitä tekee |
|---|---|
| Strict-Transport-Security | Pakottaa selaimen käyttämään https:ää (includeSubDomains ja preload suositeltuja) |
| Content-Security-Policy | Rajoittaa, mistä sivu saa ladata resursseja, ja estää XSS-hyökkäyksiä |
| X-Content-Type-Options: nosniff | Estää selainta arvaamasta tiedostotyyppiä |
| X-Frame-Options: SAMEORIGIN | Estää sivun upottamisen toisen sivuston iframeen |
| Referrer-Policy | Määrittää, mitä tietoa välitetään, kun kävijä klikkaa linkkiä |
SPF, DKIM ja DMARC eivät ole teknistä SEO:ta, mutta jos domainisi lähettää tarjouksia tai uutiskirjeitä, niiden on oltava kunnossa. Muuten viestit päätyvät roskapostiin ja domainin luotettavuus kärsii.
Mitä rakennedata tarkoittaa teknisessä SEO:ssa?
Rakennedata (Schema Markup) on JSON-LD-merkintä, joka kertoo Googlelle, mitä sivu on: artikkeli, yritys, palvelu tai henkilö. Se ei suoraan nosta sijoituksia, mutta mahdollistaa rich resultit, kuten murupolut ja yritystiedot, ja auttaa myös tekoälyhakuja tunnistamaan entiteetit. Google suosittelee Organization- ja WebSite-tietoja etusivulle, ei jokaiselle sivulle.
| Tyyppi | Käyttökohde | Rich result |
|---|---|---|
| Organization | Etusivu: nimi, logo, yhteystiedot | Tietopaneeli |
| LocalBusiness | Paikallinen yritys: osoite, aukioloajat, palvelualue | Kartat ja paikallinen haku |
| Article / BlogPosting | Artikkelit: kirjoittaja, julkaisuaika, kuva | Artikkelin tiedot |
| BreadcrumbList | Navigaatiopolku | Murupolku hakutuloksessa |
| Service | Palvelusivut: palvelun tyyppi ja alue | Palvelun tiedot |
| FAQPage, HowTo | UKK ja ohjeet | Ei enää tavallisille sivustoille (FAQ vain viranomais- ja terveyssivuille elokuusta 2023) |
Lisää rakennedata JSON-LD:nä ja validoi se aina Rich Results Testillä tai Schema Markup Validatorilla.
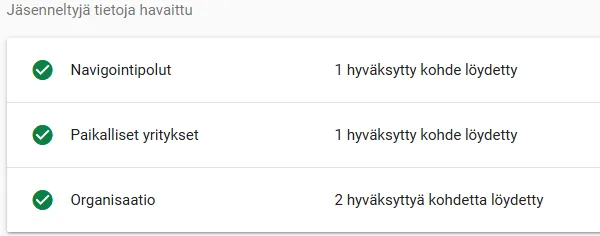
Rakennedata kannattaa keskittää. Tällä sivustolla yritys, henkilö ja paikallinen yritys määritellään kerran etusivulla @id-tunnisteella, ja artikkelit viittaavat niihin. Miten se nopeuttaa korjauksia, näkyy esimerkissä 1.
Sivuarkkitehtuuri ja sisäinen linkitys
Sivuarkkitehtuuri kertoo, miten sivut on järjestetty ja miten ne linkittävät toisiinsa. Hyvä rakenne auttaa kävijää löytämään etsimänsä ja Googlebotia crawlaamaan tehokkaasti. Kolme mittaria riittää: klikkaussyvyys, sivut ilman sisäisiä linkkejä ja ankkuritekstit.
Klikkaussyvyys (crawl depth) kertoo, montako klikkausta etusivulta tarvitaan sivulle. Tärkeiden sivujen pitäisi olla enintään kolmen klikkauksen päässä. Tällä sivustolla (Screaming Frog 12.10.2026) etusivu on tasolla 0, 17 sivua tasolla 1, 26 sivua tasolla 2 ja yksi sivu tasolla 3.
Sisäiset linkit jakavat sivujen arvoa. Jokaiselle sivulle pitää johtaa vähintään yksi linkki, ankkuritekstin pitää kertoa kohteen aihe (“lue teknisen SEO:n tarkistuslista”, ei “klikkaa tästä”) ja artikkelin pitää linkittää saman aiheen artikkeleihin ja palvelusivulle.
Murupolku (Etusivu › Blogi › Tekninen SEO) näyttää kävijälle sijainnin ja Googlelle hierarkian. Toteuta se HTML:nä sivun yläosaan ja BreadcrumbList-rakennedatana.
Tehokkain tapa järjestää sisältö on pillar-cluster-malli: pilarisivu käsittelee laajan aiheen, klusterisivut syventävät osa-alueita ja kaikki ohjaavat palvelusivulle. Malli on piirretty auki hakukoneoptimoinnin oppaassa.
Miten JavaScript-renderöinti vaikuttaa indeksointiin?
Google näkee staattisen HTML:n heti. JavaScriptillä selaimessa luotu sisältö siirtyy erilliseen renderöintijonoon, ja se voi näkyä haussa päiviä tai viikkoja myöhemmin. Tämä on suurin tekninen SEO-riski React-, Vue- ja Angular-sovelluksissa, jotka renderöivät oletuksena selaimessa.
| Renderöintitapa | Mitä tapahtuu | Googlen näkökulmasta | Esimerkkejä |
|---|---|---|---|
| CSR (selaimessa) | Palvelin lähettää tyhjän sivun ja JavaScriptin, selain rakentaa sisällön | Sisältö näkyy vasta renderöinnin jälkeen, viiveellä | React-, Vue- ja Angular-sovellukset oletuksena |
| SSR (palvelimella) | Palvelin tuottaa valmiin HTML:n jokaiseen pyyntöön | Sisältö näkyy heti | Next.js, Nuxt |
| SSG (buildissa) | HTML tuotetaan valmiiksi julkaisun yhteydessä | Sisältö näkyy heti, ja sivu on nopein | Astro, Hugo, Next.js static export |
Viive on kriittinen aikaherkälle sisällölle: kampanjasivuille, uusille tuotteille ja päivittyville hinnoille. Jos haku näyttää vanhaa hintaa viikkoja, syy on usein renderöintijonossa.
Tarkista renderöinti näin:
- Avaa sivun lähdekoodi. Paina Ctrl+U (Macissa Cmd+Option+U). Jos tärkeä teksti puuttuu ja näet vain skriptejä, sivu renderöidään selaimessa.
- Testaa ilman JavaScriptiä. Poista JavaScript käytöstä Chromen kehitystyökaluista ja lataa sivu uudelleen. Mikä katoaa, sitä Google ei näe ennen renderöintiä.
- Katso Googlen näkymä. Search Consolen URL-tarkistus näyttää testatun sivun HTML:n renderöinnin jälkeen. Vertaa sitä selaimen näkymään.
- Crawlaa JavaScript-tilassa. Screaming Frog osaa renderöidä sivut ja kertoo, millä sivuilla sisältöä tai linkkejä syntyy vasta JavaScriptillä.
Tällä sivustolla Astro tuottaa kaiken sisällön HTML:nä buildissa. Screaming Frog löysi JavaScriptillä syntyvää sisältöä kolmelta sivulta, ja se on ajanvarauskomponentti, ei hakuun tarkoitettua tekstiä.
Tekninen SEO ja tekoälyhaut
Tekoälyhaut (Googlen AI Overview, ChatGPT, Perplexity) käyttävät samaa perustaa kuin perinteinen haku. Jos sivustoa ei voi crawlata, tekoäly ei voi siteerata sitä. Ne suosivat rakenteeltaan selkeää sisältöä (määritelmät, taulukot, listat) ja luotettavia lähteitä. Kun tekninen perusta on kunnossa, seuraava työ on tekoälyoptimointi.
Robots.txt on paikka, jossa päätät tekoälycrawlerien pääsystä:
| Crawleri | Yritys | Tarkoitus |
|---|---|---|
| GPTBot | OpenAI | ChatGPT ja mallien koulutus |
| OAI-SearchBot | OpenAI | ChatGPT:n haku |
| ClaudeBot | Anthropic | Claude ja mallien koulutus |
| PerplexityBot | Perplexity | Tekoälyhaku |
| Google-Extended | Geminin koulutus (ei vaikuta Google-hakuun) |
Jos haluat näkyä tekoälyhauissa, älä estä näitä. Jos haluat estää vain koulutuskäytön, estä Google-Extended ja salli hakucrawlerit.
llms.txt on vapaaehtoinen tiedosto, joka kuvaa sivuston sisällön kielimalleille. Tällä sivustolla se on käytössä, mutta toistaiseksi ei ole näyttöä siitä, että se parantaisi näkyvyyttä. Hyvä lisä, ei prioriteetti.
Keksityt osoitteet ovat uusi ilmiö: tekoäly voi viitata osoitteeseen, jota ei ole olemassa, esimerkiksi /blogi/tekninen-seo-opas/. Seuraa 404-raporttia, ja jos tällainen osoite saa liikennettä, ohjaa se 301:llä oikealle sivulle.
Hreflang ja monikielisyys
Jos sivustolla on useita kieliversioita, hreflang-merkinnät kertovat Googlelle, mikä sivu on millä kielellä ja mitkä sivut ovat toistensa käännöksiä. Ilman niitä Google voi näyttää hakijalle väärän kieliversion.
<link rel="alternate" hreflang="fi" href="https://domain.fi/sivu/" />
<link rel="alternate" hreflang="en" href="https://domain.fi/en/page/" />
<link rel="alternate" hreflang="x-default" href="https://domain.fi/sivu/" />
Jokaisen kieliversion on viitattava toiseen ja itseensä, ja x-default kertoo, mikä versio näytetään muille. Tämä sivusto on suomeksi ja englanniksi (17 englanninkielistä sivua). Screaming Frog 12.10.2026: hreflang kaikilla 46 sivulla. Ainoa huomautus koskee tietosuojaselostetta: se on tarkoituksella noindex, joten sen kieliversiopari viittaa sivuun, jota ei indeksoida.
Uudelleenohjaukset
Uudelleenohjauksia tarvitaan, kun osoite muuttuu, sivu poistuu tai sisältöä yhdistetään. Oikein tehtyinä ne eivät haittaa.
| Tyyppi | Milloin ja miten |
|---|---|
| 301 (pysyvä) | Sisältö on siirtynyt pysyvästi. Siirtää linkkien arvon uuteen osoitteeseen. |
| 302 (väliaikainen) | Sisältö on hetken muualla. Ei sovi pysyviin muutoksiin. |
| Ketju (A → B → C) | Jokainen hyppy hidastaa ja kuluttaa crawlausta. Lyhennä suoraksi A → C. |
| Silmukka (A → B → A) | Google lopettaa crawlauksen, eikä sivu indeksoidu. Korjaa heti. |
Tarkista tilanne Screaming Frogista: Response Codes › Internal Redirection (3xx). Yksi tai kaksi sisäistä uudelleenohjausta on normaalia. Kymmenen tai enemmän kertoo, ettei osoitemuutoksia ole suunniteltu. Tällä sivustolla sisäisiä 3xx-vastauksia oli 12.10.2026 nolla: linkit osoittavat suoraan lopulliseen osoitteeseen.
Crawl budget: milloin sillä on väliä?
Crawl budget tarkoittaa, montako sivua Googlebot crawlaa sivustoltasi tietyssä ajassa. Se on todellinen rajoite vasta yli 10 000 sivun sivustoilla tai kun suurin osa osoitteista on parametreja, suodatinvariantteja tai ohuita sivuja. Myös hidas palvelin ja uudelleenohjausketjut kuluttavat sitä.
Pk-yrityksen 30–200 sivun sivustolla crawl budget ei rajoita mitään. Tämän sivuston 46 HTML-sivua crawlautuivat Screaming Frogilla alle kahdessa minuutissa. Panosta silloin sisältöön ja linkkeihin. Seuraa tilannetta Search Consolen Crawlaustilastoista: crawlaako Google säännöllisesti, nouseeko vastausaika ja kasvaako “crawlattu, ei indeksoitu” -sivujen määrä.
Rikkinäiset sivut ja linkit
Jokainen rikkinäinen linkki vie kävijän virhesivulle ja hukkaa linkin arvon. Ne syntyvät, kun sivuja poistetaan, osoitteita muutetaan tai ulkoiset sivustot poistavat sivujaan. Löydät ne Search Consolen Sivut-raportista (“Ei löydy (404)”), Screaming Frogista (Response Codes › Internal Client Error (4xx) ja Inlinks) sekä backlink-työkalujen rikkinäisten linkkien raportista.
| Tilanne | Korjaus |
|---|---|
| Sivu on siirtynyt uuteen osoitteeseen | 301 vanhasta uuteen ja sisäiset linkit suoraan uuteen |
| Sivu on poistettu, sisältö on muualla | 301 lähimpään vastaavaan sivuun |
| Sivu on poistettu, korvaavaa ei ole | 410 (Gone) ja sisäiset linkit pois |
| Ulkoinen linkki osoittaa vanhaan osoitteeseen | 301 ja pyyntö linkittäjälle päivittää linkki |
Tällä sivustolla 12.10.2026: 0 sisäistä 4xx-virhettä ja 4 rikkinäistä ulkoista linkkiä kolmansien osapuolten sivuille. Sisäiset korjataan aina ensin, koska ne ovat omassa hallinnassa.
Teknisen SEO:n mittaaminen
Mittaamaton tekninen SEO on arvailua. Ilman lähtötilannetta et tiedä, paransiko muutos jotain vai rikkoiko se jotain.
| Mittari | Työkalu | Mitä seuraat |
|---|---|---|
| Indeksoidut sivut | Search Console, Sivut | Kasvaako indeksi, ja mitkä syyt jättävät sivuja pois? |
| Crawlaus | Search Console, Crawlaustilastot | Crawlaako Google säännöllisesti, ja onko vastausaika noussut? |
| Core Web Vitals (kenttä) | Search Console, CrUX | Pysyvätkö LCP, INP ja CLS hyvällä alueella? |
| Orgaaninen liikenne ja konversiot | GA4 | Näkyykö korjaus liikenteessä ja yhteydenotoissa? |
| 404-virheet | Search Console, Screaming Frog | Laskeeko virheiden määrä korjausten jälkeen? |
| Rakennedata | Search Console, Parannukset | Toimiiko rakennedata ilman virheitä? |
- Lähtötilanne
- Yksi muutos
- Odota 2–4 vk
- Vertaa
- Euroiksi
- Dokumentoi lähtötilanne. Tallenna Search Consolen Sivut-raportti ja Core Web Vitals ennen muutosta.
- Tee yksi muutos kerrallaan. Jos muutat kaiken kerralla, et tiedä, mikä vaikutti.
- Odota 2–4 viikkoa. Crawlaus, indeksointi ja uudelleenarviointi vievät aikaa.
- Vertaa samoja mittareita samalta ajalta. Search Consolessa vertaa kolmea kuukautta edelliseen kolmeen.
- Yhdistä tulos euroihin. Tekninen korjaus näkyy ensin indeksissä, sitten orgaanisessa liikenteessä ja lopulta yhteydenotoissa tai myynnissä.
Tekninen SEO ei ole kertaprojekti. Sivustoon lisätään sivuja, vanhoja poistetaan ja päivitykset rikkovat asioita.
Käytännön esimerkkejä: tekninen SEO toimenpiteissä
Kaksi tapausta näyttää, miltä tekninen korjaus näyttää ennen ja jälkeen.
Esimerkki 1: rakennedatan korjaus kolmessa päivässä
Tämän sivuston Screaming Frog -crawl 16.4.2026 raportoi 20 rich result -varoitusta 28 sivulla. Artikkelien author-tieto oli merkkijono, ja LocalBusiness-tiedoista puuttuivat koordinaatit viideltä palvelusivulta.
16.4.2026
20 varoitusta
19.4.2026, parempi vaihtoehto
@id-viittauksella, koordinaatit ja aukioloajat lisätty. Yksi muutos asettelutiedostoon korjasi kaikki artikkelit, koska rakennedata on keskitetty.1 varoitus
Jos jokaisella sivulla olisi ollut oma kopio rakennedatasta, sama korjaus olisi vaatinut 28 erillistä muokkausta. Keskitetty rakenne tekee korjauksesta yhden muutoksen.
Esimerkki 2: robots.txt esti kuvat (asiakastapaus)
WordPress-sivuston liikenne laski 40 % kuukaudessa. Search Console näytti kahdeksalle sivulle tilan “Estetty robots.txt-tiedostolla”.
Virheen jälkeen
Disallow: /wp-content/uploads/ säästääkseen crawlausta. Google ei pystynyt renderöimään sivuja oikein, koska kuvat eivät latautuneet.−40 %
3 viikon kuluttua, parempi vaihtoehto
Palautui
Opetus: älä estä robots.txt:llä resursseja, joita Google tarvitsee sivun renderöintiin. Jos sivustosi on WordPressissä, WordPress-hakukoneoptimoinnin oppaassa on alustan omat tarkistukset.
Tekninen SEO-auditointi: tarkistuslista
Nämä kymmenen kohtaa kattavat kriittisimmät asiat. Merkitse ne, jotka ovat kunnossa: lista muistaa valintasi tällä laitteella.
Tarkista oma sivustosi
0 / 10 tehty
Haluatko, että katson loput puolestasi? Varaa maksuton kartoitus.
Kuukausittaiset ja neljännesvuosittaiset tarkistukset Loput kohdat: metatiedot, kuvat, tietoturva, hreflang ja tekoälycrawlerit.
Kuukausittain:
- Kaikilla sivuilla on title, H1 ja metakuvaus.
- Kuvilla on alt-teksti sekä leveys ja korkeus.
- Duplikaatteja ei ole (Screaming Frog › Content › Duplicates).
- Mixed content -varoituksia ei ole.
- Mobiilissa ei ole koko ruudun peittäviä ponnahdusikkunoita.
Neljännesvuosittain:
- Tietoturvaheaderit (HSTS, CSP, X-Content-Type-Options) ovat kunnossa.
- SPF ja DMARC ovat DNS-tietueissa.
- Jokaiselle sivulle johtaa vähintään yksi sisäinen linkki, ja tärkeät sivut ovat enintään kolmen klikkauksen päässä.
- Hreflang on oikein, jos sivusto on monikielinen.
- Murupolku ja BreadcrumbList validoituvat.
- Tekoälycrawlerien pääsy on tietoinen päätös robots.txt:ssä ja CDN:ssä.
- 404-raportista on tarkistettu tekoälyn keksimät osoitteet.
Työkalut
| Työkalu | Mitä tekee | Hinta |
|---|---|---|
| Google Search Console | Indeksointi, hakukyselyt, Core Web Vitals -kenttädata, URL-tarkistus | Ilmainen |
| PageSpeed Insights | Core Web Vitals -mittaus ja korjausehdotukset | Ilmainen |
| Screaming Frog | Crawlaus: linkit, canonicalit, rakennedata, vastauskoodit, renderöinti | Ilmainen 500 osoitteeseen, laajempi lisenssi vuosimaksulla |
| Rich Results Test | Rakennedatan validointi ja esikatselu | Ilmainen |
| Chrome DevTools | Lighthouse, verkkoliikenne, JavaScriptin tarkistus | Ilmainen |
| Ahrefs tai Semrush | Automaattinen auditointi, backlinkit, kilpailijat | Kuukausimaksu |
Search Console on pakollinen, koska se on ainoa lähde Googlen omaan indeksointidataan. Screaming Frog löytää rikkinäiset linkit, duplikaatit, puuttuvat canonicalit ja rakennedatan virheet yhdellä crawlilla. Maksulliset työkalut kannattaa ottaa vasta, kun tarvitset backlink-dataa tai kilpailija-analyysia.
Milloin tekninen SEO kannattaa ostaa palveluna?
Perustarkistukset voi tehdä itse. Palveluna tekninen SEO kannattaa ostaa, kun ongelma näkyy jo euroissa tai riski on liian suuri arvailtavaksi:
- Orgaaninen liikenne on laskenut, eikä syy näy sisällöstä.
- Sivusto on juuri uudistettu, siirretty uudelle alustalle tai osoitteet ovat muuttuneet.
- Search Console näyttää paljon indeksointi-, canonical- tai 404-ongelmia.
- Sivusto on hidas mobiilissa, eivätkä kehittäjät tiedä juurisyytä.
- Verkkokaupan suodattimet ja variantit tuottavat tuhansia osoitteita.
- Sivusto on rakennettu JavaScript-sovelluksena, ja sivut indeksoituvat hitaasti.
Hyvä tekninen auditointi ei ole lista sadasta irrallisesta virheestä. Se kertoo, mikä estää näkyvyyttä, mikä heikentää konversiota ja missä järjestyksessä korjaukset kannattaa tehdä. Mitä koko SEO-auditointiin kuuluu tekniikan lisäksi ja miten arvioit saamasi raportin, kerron omassa artikkelissaan.
Teknisen auditoinnin ja korjausten hinnoista kerron tarkemmin hakukoneoptimoinnin hintaoppaassa.